3줄 요약
- AI 텍스트 워터마크는 글에 숨은 문자를 넣는 기술이 아닙니다. AI가 다음 단어를 고를 때 쓰는 무작위 값을 비밀 키로 정해 단어 선택에 통계적 흔적을 남기고, 키를 가진 회사만 그 흔적을 확인할 수 있습니다.
- 2026년 10월 기준 구글 제미나이, Anthropic 클로드, OpenAI ChatGPT·Codex(EU 지역)가 텍스트에 워터마크를 넣습니다. 2026년 8월 2일부터 적용된 EU AI법 제50조가 계기입니다.
- 구글은 콘텐츠를 만든 방식이 아니라 품질을 평가한다는 입장이고, 워터마크를 검색 순위나 AI 답변의 출처 선택에 쓴다고 밝힌 검색 서비스는 없습니다. 검색 노출에서 문제가 되는 것은 워터마크가 아니라 가치를 더하지 않고 대량으로 만든 글입니다.
2026년 8월 Anthropic이 클로드가 만드는 글에 워터마크를 넣는다고 발표하자, 링크드인과 X에서는 “이제 클로드로 쓴 글은 구글에서 순위가 안 나온다”는 말이 돌았습니다. 10월에는 OpenAI도 EU 지역 ChatGPT 답변에 워터마크를 넣겠다고 밝혔습니다. AI로 블로그와 홈페이지 글을 만드는 기업이라면 워터마크가 어떻게 작동하는지, 어느 AI에 들어가 있는지, 검색 노출에 영향이 있는지가 궁금할 수밖에 없습니다. 원 논문과 각 회사의 공식 문서, EU 규정 자료를 확인해 정리했습니다.
AI 텍스트 워터마크란?
AI 텍스트 워터마크는 AI가 만든 글에 사람 눈에는 보이지 않지만 정해진 키로 확인할 수 있는 표시를 남기는 기술입니다. 사진 구석에 찍는 로고와 달리 글자 모양과 내용은 그대로이고, 표시는 단어를 어떻게 골랐는지에 통계적으로 남습니다. Anthropic은 워터마크 설명 글에서 글에 더해지는 것이 없고 숨은 문자도 없으며, 토큰을 더 쓰지 않아 비용도 같다고 밝혔습니다.
AI가 만든 글을 알아보는 방법은 워터마크, 메타데이터, AI 탐지기 세 가지로 나뉩니다. 이름이 비슷해 자주 섞이지만 작동 방식과 확인할 수 있는 사람이 다릅니다.
| 방식 | 표시가 남는 곳 | 확인하는 쪽 | 한계 |
|---|---|---|---|
| 텍스트 워터마크 | 단어 선택의 통계적 패턴 | 키를 가진 AI 회사와 회사가 허용한 기관 | 짧은 글, 많이 고친 글, 번역한 글에서는 약해짐 |
| 메타데이터(C2PA) | 이미지·영상 같은 파일에 붙는 서명 정보 | C2PA를 지원하는 도구를 쓰는 누구나 | 일반 텍스트에는 붙일 곳이 없고, 파일 변환이나 캡처로 사라짐 |
| AI 탐지기 | 별도 표시 없음 | 탐지 서비스 | 키가 없어 문체와 단어 빈도로 추정만 함 |
Anthropic은 시중 AI 탐지 소프트웨어가 키 없이 AI 문장에 자주 나오는 말투를 찾아내는 방식이라 워터마크 확인과는 근본적으로 다르다고 설명했습니다. 이미지 같은 파일에는 워터마크 대신 C2PA 콘텐츠 자격 증명이라는 서명된 메타데이터를 붙입니다.
워터마크는 단어를 고르는 무작위 값에 흔적을 남깁니다
대형 언어 모델은 글을 한 번에 한 토큰(단어나 단어 조각)씩 만듭니다. 매번 다음에 올 후보마다 확률을 계산하고 그중 하나를 무작위로 뽑습니다. Anthropic이 든 예를 우리말로 옮기면, “오늘 날씨는 춥고” 다음에는 “흐렸다”와 “잿빛이었다”가 둘 다 자연스럽고 어느 쪽을 골라도 뜻은 거의 같습니다. 이런 갈림길에서는 보통 무작위 값이 선택을 정합니다.
워터마크는 이 무작위 값을 비밀 키와 바로 앞의 몇 단어로 정합니다. 읽는 사람에게는 여전히 무작위 선택으로 보이지만, 키를 가진 쪽은 글 전체의 단어 선택이 키로 계산한 값과 얼마나 맞는지 점수를 낼 수 있습니다. 갈림길이 수백 번 쌓이면 우연으로 보기 어려운 일치가 나타나고, 이를 근거로 특정 AI가 관여했을 가능성을 판단합니다.
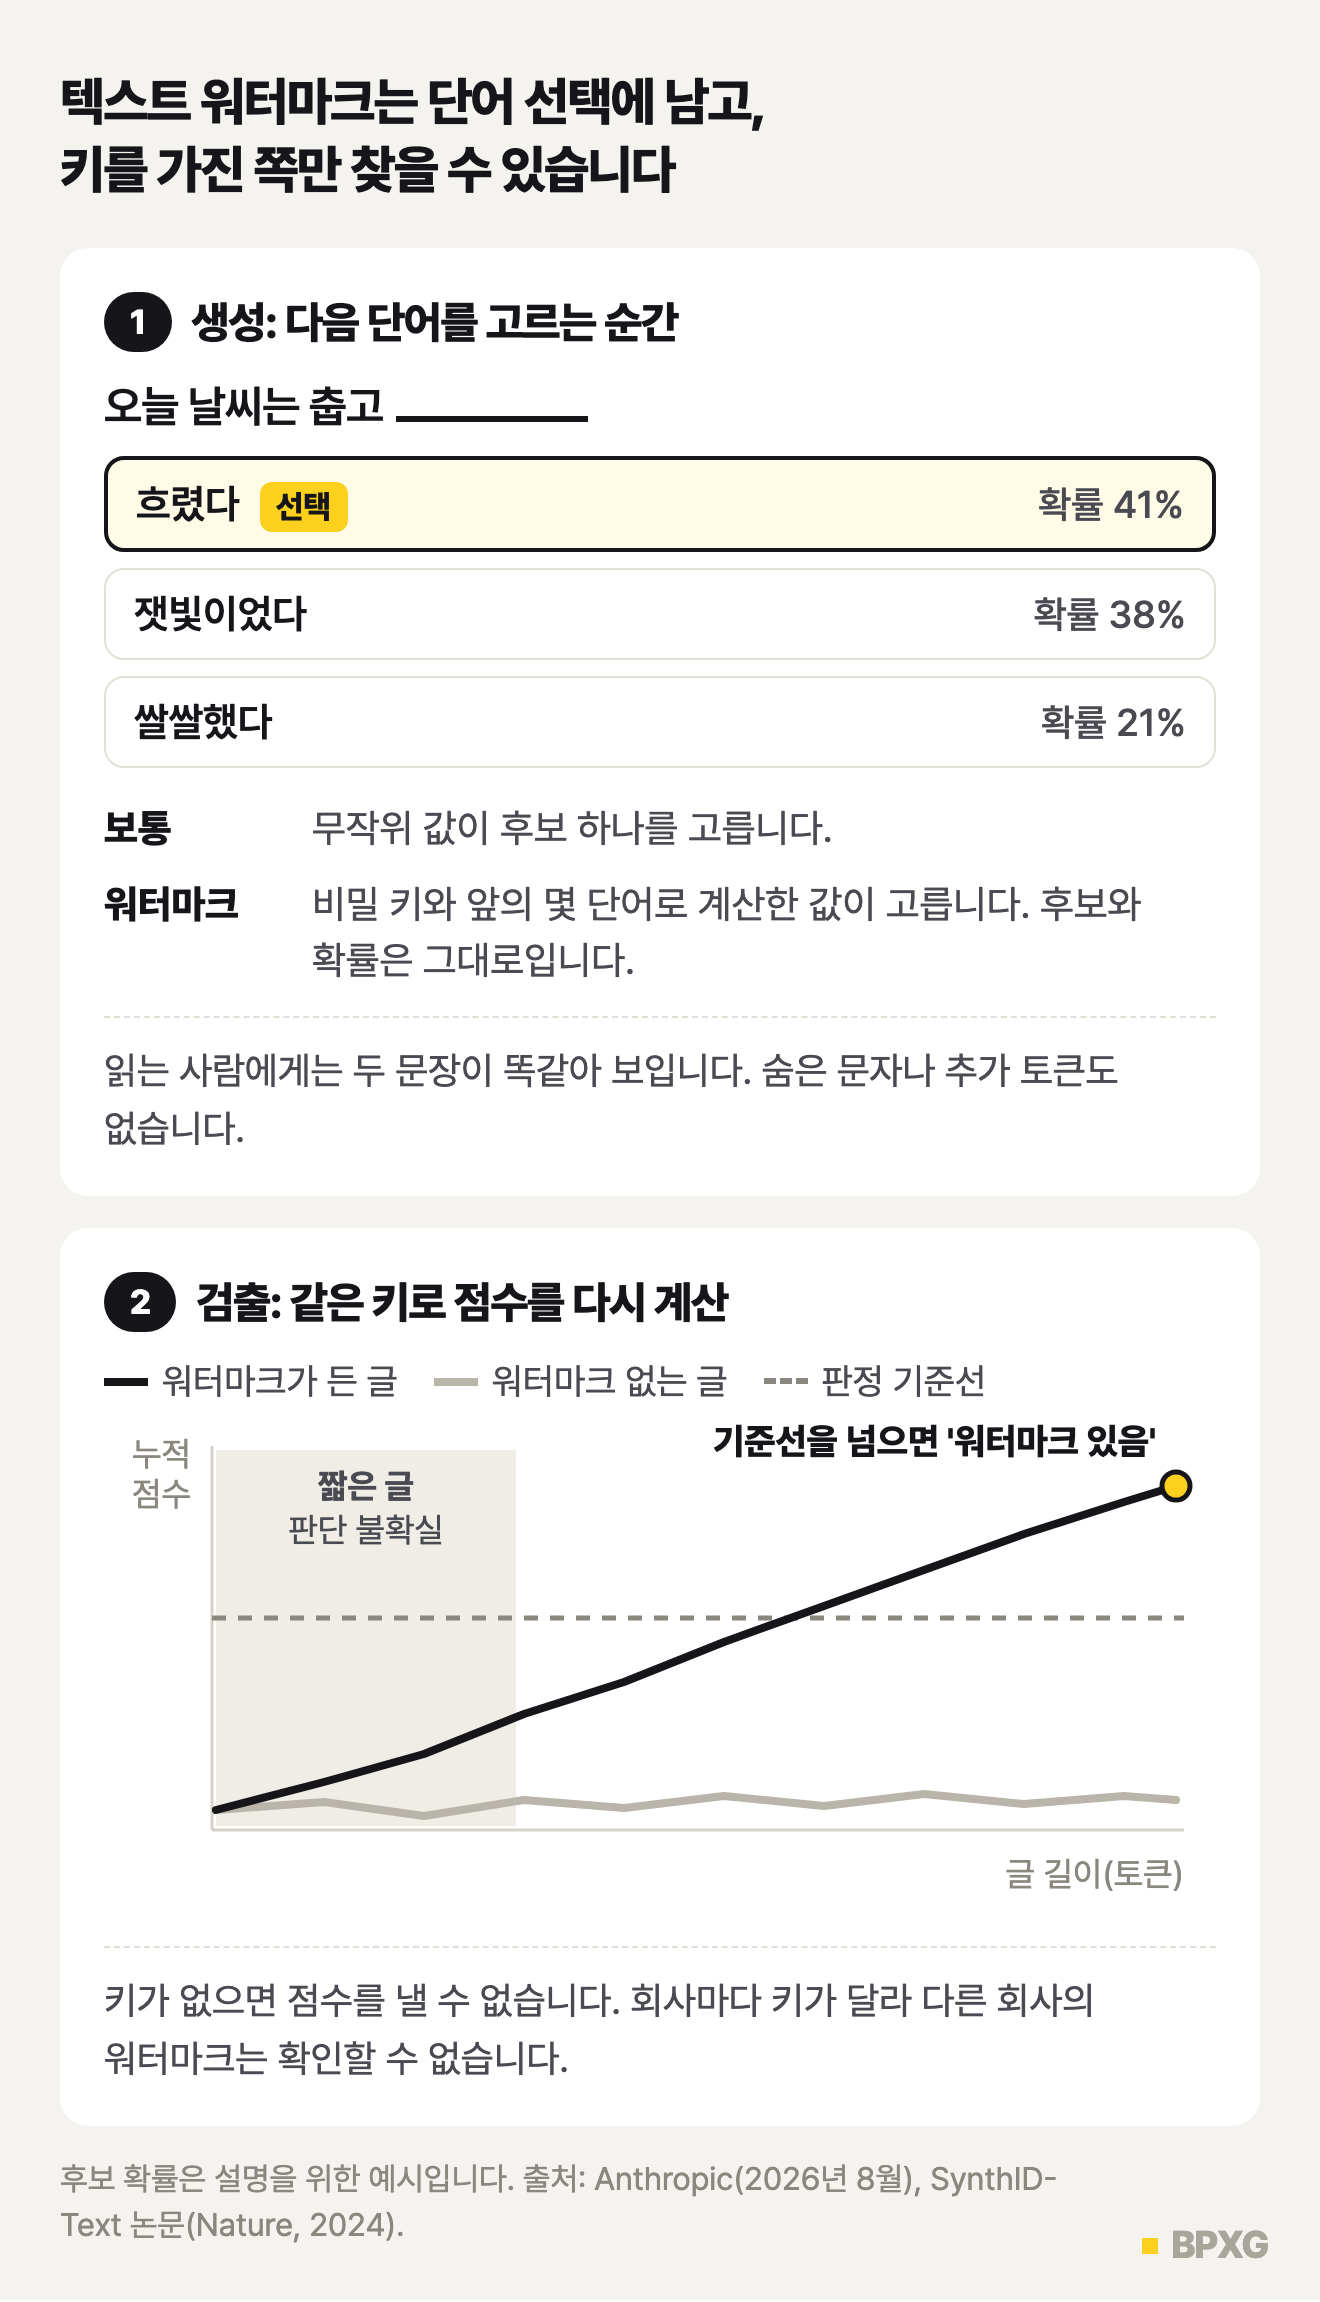
구현 방식은 크게 두 갈래입니다. 첫째는 메릴랜드대 연구진이 2023년 발표한 그린 리스트 방식입니다. 앞 토큰과 키로 어휘를 ‘그린’과 ‘레드’ 목록으로 나누고 그린 목록 단어의 확률을 조금 올립니다. 검출할 때는 글에 그린 단어가 몇 개인지 세어 통계 검정을 하며, 모델에 접근하지 않고도 키와 토크나이저만 있으면 됩니다. 논문은 128토큰 길이 실험에서 생성 글의 98.4%를 검출했다고 보고했습니다. 확률 분포를 직접 바꾸기 때문에 글의 단어 분포가 조금 달라집니다.
둘째는 확률 분포는 그대로 두고, 후보 가운데 하나를 뽑는 무작위 값만 키로 정하는 방식입니다. 2022년 당시 OpenAI에서 일하던 컴퓨터과학자 스콧 애런슨이 제안했고, 구글 딥마인드가 2024년 네이처에 발표한 SynthID-Text도 이 계열입니다. SynthID-Text는 앞 4개 토큰과 키로 무작위 시드를 만들고, 후보 단어끼리 여러 차례 겨루게 하는 ‘토너먼트 샘플링’으로 하나를 고릅니다. Anthropic은 클로드의 워터마크가 SynthID-Text를 바탕으로 한 방식이라고 밝혔습니다. OpenAI의 textGrain도 키로 만든 무작위 값에 단어 선택을 묶는 방식이고, 답변의 다양성을 얼마나 줄일지 예산을 정해 워터마크 강도를 조절합니다.
선택지가 적은 글에는 흔적이 적게 남습니다
워터마크는 갈림길이 있어야 남습니다. Anthropic은 “아이작 뉴턴의 대표작은 프린키피아” 다음에는 “마테마티카” 말고 다른 답이 없으므로 워터마크가 작용할 곳이 없다고 설명했습니다. 같은 이유로 사실 위주의 문장, 정확해야 하는 코드, 문법만 고친 교정 결과에는 흔적이 적게 남습니다. 반대로 클로드가 번역한 글에는 워터마크가 들어갑니다. 번역문의 단어를 모두 클로드가 골랐기 때문입니다.
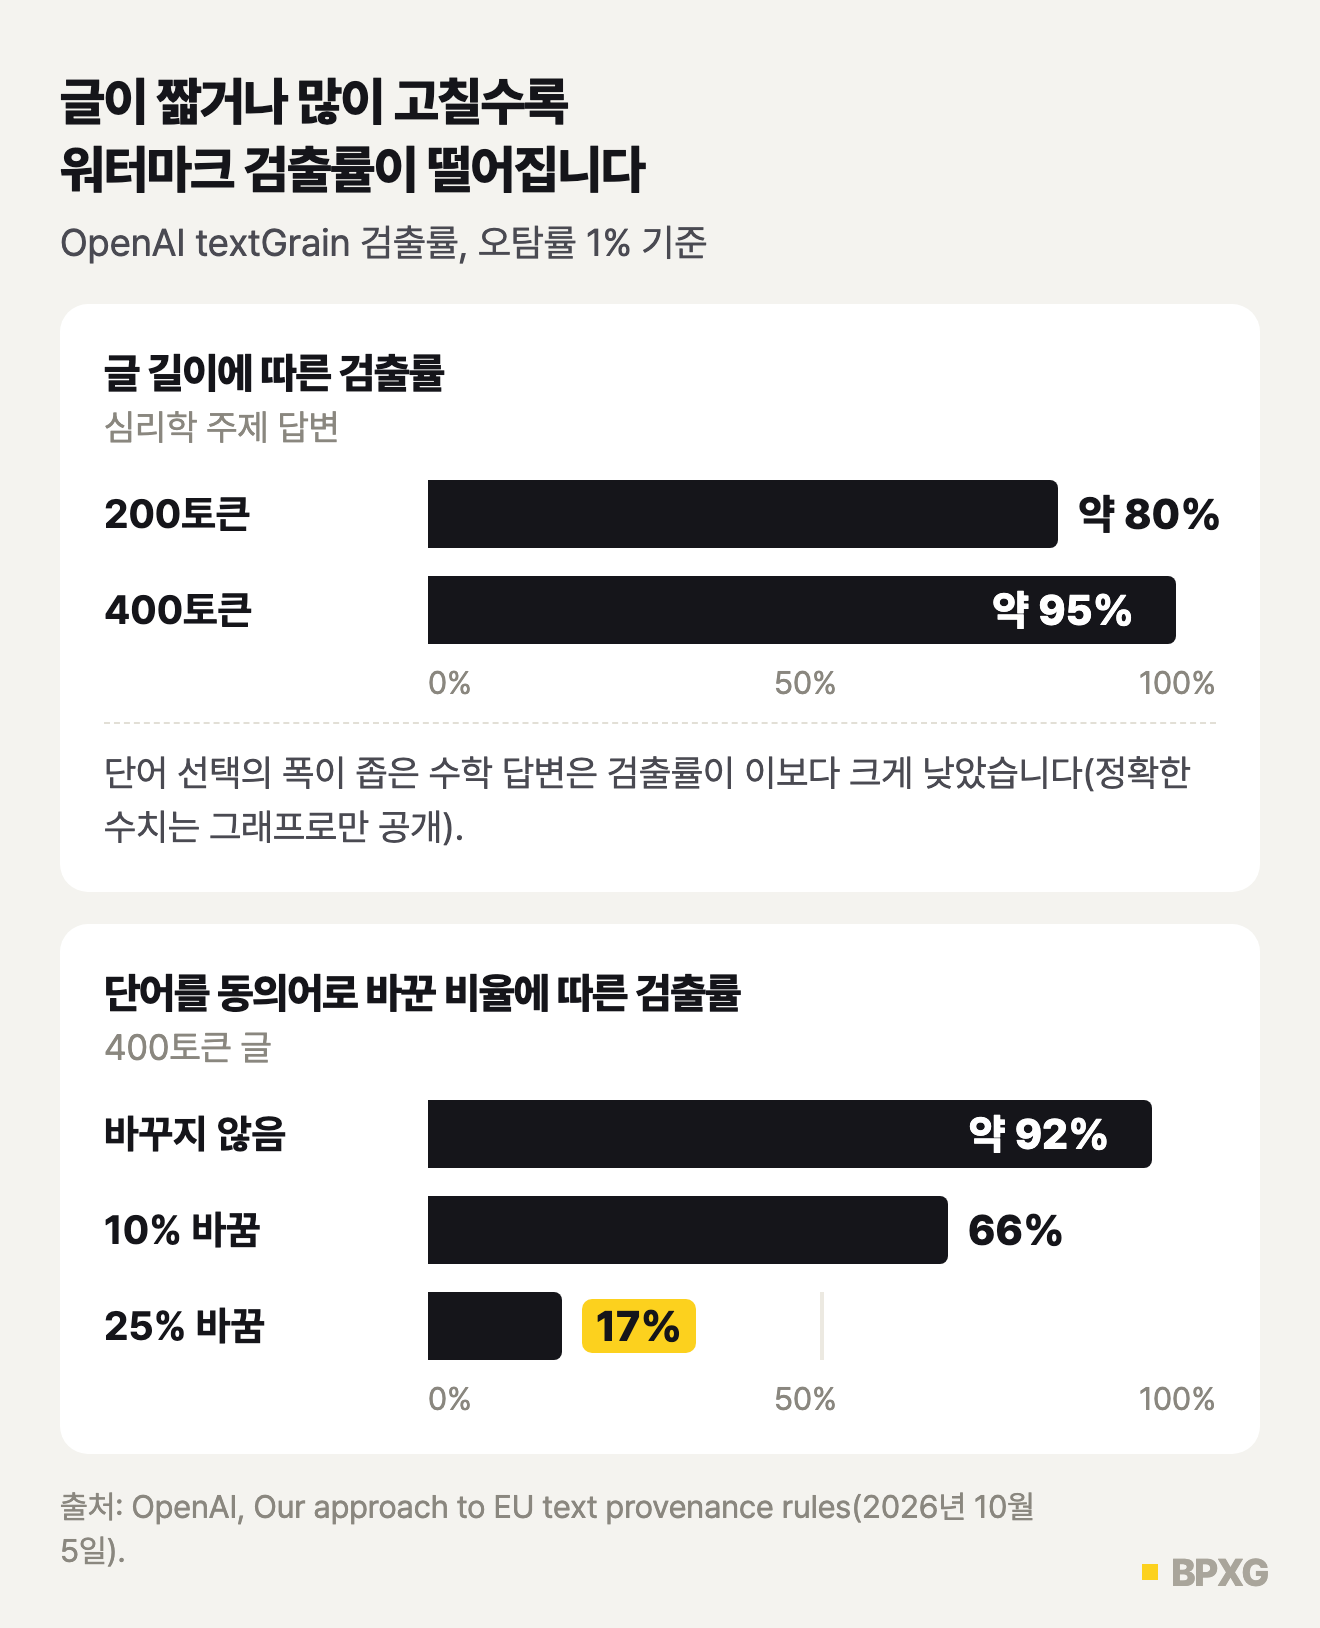
글의 길이도 검출을 좌우합니다. OpenAI의 공개 자료에 따르면 워터마크가 없는 글을 있다고 잘못 판정하는 비율을 1%로 맞췄을 때, 심리학 주제 답변에서 200토큰 글의 약 80%, 400토큰 글의 약 95%를 검출했습니다. 단어 선택의 폭이 좁은 수학 답변은 검출률이 크게 낮았습니다. EU 실천 강령도 200토큰(영어 약 150단어) 미만 텍스트는 워터마크 의무에서 제외했습니다.
고쳐 쓰면 약해지고, 키 없이는 확인할 수 없습니다
워터마크는 단어 선택에 남기 때문에 단어를 바꾸면 약해집니다. OpenAI가 400토큰 글로 시험한 결과, 단어의 10%를 동의어로 바꾸자 검출률이 약 92%에서 66%로, 25%를 바꾸자 17%로 떨어졌습니다. Anthropic도 가벼운 편집으로는 워터마크가 완전히 사라지지 않지만, 모든 단어를 바꿔 다시 쓰면 사라진다고 밝혔습니다.
번역도 워터마크를 약하게 만듭니다. 스탠퍼드대 연구진은 워터마크가 든 영어 글을 러시아어로 번역했다가 다시 영어로 옮기면, 시험한 방식 대부분이 워터마크를 안정적으로 찾지 못했다고 보고했습니다. OpenAI가 2024년 8월 텍스트 워터마크 공개를 미룬 이유도 여기에 있었습니다. 당시 OpenAI는 번역이나 다른 AI로 다시 쓰는 방식에 약하고, 영어가 모국어가 아닌 사람들이 AI를 글쓰기 도구로 쓰는 것에 낙인을 찍을 수 있다고 설명했습니다.
검출 도구는 아직 일부 기관에만 열려 있습니다
워터마크는 키를 가진 회사만 확인할 수 있고, 회사마다 키가 다릅니다. Anthropic은 자사 키로는 “이 글의 일부를 클로드가 썼을 가능성”만 판단할 수 있고, 다른 AI가 쓴 글인지는 알 수 없다고 밝혔습니다. 2026년 10월 현재 텍스트 검출 도구를 누구나 쓸 수 있게 공개한 회사는 없습니다. OpenAI는 승인된 연구자와 전문 기관에 먼저 열었고, Anthropic은 규제 기관, 수사 기관, 언론, 팩트체커, 연구자, 교육 기관 등에 비공개 프리뷰로 제공합니다. 구글이 10월 7일 전 세계에 공개한 SynthID Detector는 이미지, 영상, 오디오를 확인하는 도구입니다.
검출 결과가 알려 주는 범위도 좁습니다. OpenAI는 워터마크가 사람이 얼마나 기여했는지, 누가 글의 주인이고 누가 썼는지, 내용이 정확한지는 알려 주지 않는다고 밝혔습니다. 워터마크가 검출되지 않았다고 해서 사람이 쓴 글이라는 증거가 되지도 않습니다. 글이 짧거나 고쳐졌거나 번역되었을 수 있고, 워터마크를 넣지 않는 모델이나 다른 회사 도구로 만든 글일 수도 있기 때문입니다.
숨은 문자는 워터마크가 아닙니다
2025년 ChatGPT 답변에서 좁은 줄 바꿈 없는 공백(U+202F) 같은 특수 문자가 발견되면서 “이것이 워터마크”라는 주장이 퍼졌고, 이런 문자를 지워 준다는 ‘워터마크 제거’ 도구도 나왔습니다. 2026년 9월 발표된 케이스웨스턴리저브대 논문에 따르면 OpenAI는 이를 학습 과정의 부산물이라고 설명했습니다. 지금 회사들이 넣는 텍스트 워터마크는 숨은 문자를 넣지 않으므로, 특수 문자를 지우는 도구와는 관계가 없습니다.
텍스트 워터마크를 적용한 AI 회사와 모델
2026년 10월 28일까지 각 회사가 공개한 내용을 기준으로 정리했습니다.
| 회사 | 기술 | 적용 범위 | 검출 도구 |
|---|---|---|---|
| 구글 | SynthID-Text | 제미나이 앱·웹 텍스트(2024년부터). API·AI 스튜디오 텍스트는 개발자 포럼 답변으로만 확인됨 | 텍스트용 공개 도구 없음 |
| Anthropic | SynthID-Text 기반 | 2026년 8월 2일 이후 출시 모델은 출시부터, 이전 모델은 순차 적용. 모든 제품과 클라우드 파트너, 전 세계 | 규제·언론·연구 기관 등에 비공개 프리뷰 |
| OpenAI | textGrain | EU 지역 ChatGPT·Codex 텍스트(2026년 10월부터 단계 적용). API는 일부 모델에서 고객이 켜야 적용 | 승인된 연구자·전문 기관 |
| 메타 | TextSeal(오픈소스) | 연구 도구로 공개. 메타 AI 서비스 적용은 공식 발표를 찾지 못함 | 도구에 검출 기능 포함 |
구글: 2024년부터 제미나이에 적용
구글 딥마인드는 2024년 5월 SynthID를 제미나이 앱과 웹의 텍스트로 넓혔습니다. 네이처 논문에서는 실제 제미나이 응답 약 2,000만 건의 사용자 평가를 비교해 워터마크를 넣어도 품질 차이가 통계적으로 의미 없었다고 보고했습니다. 같은 해 10월에는 허깅페이스 트랜스포머 라이브러리에 SynthID-Text를 공개해 다른 개발사도 자기 모델에 적용할 수 있게 했습니다.
제미나이 API로 만든 텍스트에 워터마크가 들어가는지는 공식 문서에 적혀 있지 않습니다. 2026년 8월 구글 개발자 포럼에서는 담당 직원이 처음에 적용되지 않는다고 답했다가, 2주 뒤 API와 AI 스튜디오 텍스트에도 적용된다고 정정했습니다.
Anthropic: 모든 제품, 전 세계 적용
Anthropic은 2026년 8월 14일 클로드 텍스트 워터마크를 설명하는 글을 냈습니다. 지원 문서에 따르면 8월 2일 이후 출시한 모델은 출시 때부터 워터마크가 들어가고, 그 전 모델에도 순차 적용하고 있습니다. 10월 21일 갱신된 목록에는 하이쿠·소네트·오퍼스 4.5부터 최신 모델까지 올라 있습니다. 적용 범위는 API, 클로드 앱, 클로드 코드를 포함한 모든 제품이고, AWS, 구글 클라우드, 마이크로소프트 파운드리에서 쓰는 지원 모델에도 들어가며 지역 구분이 없습니다. Anthropic은 지역별로 나눠 적용할 확실한 방법이 아직 없어 전 세계에 적용한다고 설명했습니다.
OpenAI: EU 지역 ChatGPT부터
OpenAI는 2026년 10월 5일 textGrain을 발표했습니다. EU 지역 ChatGPT와 Codex의 텍스트에는 몇 주에 걸쳐 모든 요금제에 워터마크를 넣고, API에서는 일부 모델에 한해 고객이 직접 켜야 적용됩니다. 처음부터 전 세계 기본값으로 하지 않는 이유로는 실제 사용에서 배우기 위한 단계적 접근을 들었습니다. 발표대로라면 한국에서 쓰는 ChatGPT 답변은 현재 워터마크 적용 대상이 아닙니다. OpenAI는 자체 평가에서 textGrain이 SynthID-Text와 같거나 더 나은 성능을 냈고, 기술을 오픈소스로 공개할 계획이라고 밝혔습니다.
메타: 오픈소스 도구 공개
메타의 AI 서비스에 텍스트 워터마크를 적용했다는 공식 발표는 찾지 못했습니다. 대신 메타 연구진은 TextSeal을 오픈소스로 공개했습니다. 글을 만들 때 넣는 워터마크와, 이미 쓴 글을 AI로 다시 쓰면서 넣는 사후 워터마크를 모두 지원하고 검출 기능도 들어 있습니다.
규제가 텍스트 워터마크를 의무로 만들었습니다
EU AI법 제50조: AI 회사의 표시 의무
회사들이 2026년 하반기에 한꺼번에 움직인 이유는 EU AI법입니다. 제50조 2항은 텍스트를 포함한 합성 콘텐츠를 만드는 AI 시스템 제공자에게, 결과물을 기계가 읽을 수 있는 형식으로 표시하고 AI가 만든 것으로 검출할 수 있게 하라고 요구합니다. 이 의무는 2026년 8월 2일부터 적용되었고, 그 전에 출시된 시스템은 디지털 옴니버스 개정으로 2026년 12월 2일까지 유예받았습니다. 위반하면 최대 1,500만 유로 또는 전 세계 연 매출의 3% 가운데 큰 금액이 과징금으로 부과될 수 있습니다.
EU 집행위원회가 6월 10일 확정한 AI 생성 콘텐츠 투명성 실천 강령에는 7월 말까지 약 190개 기업과 기관이 서명했습니다. 강령은 원칙적으로 두 가지 이상의 표시 기술을 함께 쓰게 하지만, 메타데이터를 붙일 수 없는 일반 텍스트는 한 가지로도 인정합니다. 검출 수단은 원칙적으로 무료로 제공해야 하고, 규제 기관, 언론, 팩트체커, 연구자, 시민단체에는 제한 없이 열어야 합니다. 2027년 2월 2일까지는 회사마다 다른 검출기를 일일이 돌리지 않고도 확인할 수 있도록 상호 운용성을 갖춰야 합니다(Paul Weiss 정리).
EU AI법 제50조 4항: 글을 게시하는 쪽의 표시 의무
제50조 4항은 AI를 이용하는 쪽의 의무입니다. 공익에 관한 사안을 대중에게 알리려고 AI로 만들거나 고친 텍스트를 게시하면 AI가 만들었다는 사실을 밝혀야 합니다. 사람이 내용을 검토하고 편집 책임을 지는 경우는 예외입니다. 집행위원회가 7월 20일 확정한 지침은 이 예외를 좁게 봅니다. 해당 분야 역량이 있는 사람이 내용을 실질적으로 검토해야 하고, 맞춤법 교정이나 형식적인 승인으로는 부족하며, 책임자를 특정할 수 있어야 합니다. AI 회사가 넣은 워터마크가 게시하는 쪽의 표시 의무를 대신하지도 않습니다. 공익의 범위에는 보건, 소비자 보호, 환경, 경제 동향 등이 넓게 들어가므로, EU 독자를 대상으로 하는 건강·금융 정보 글에는 이 기준이 적용됩니다.
한국과 중국
한국은 2026년 1월 22일 시행된 AI 기본법에서 생성형 AI 결과물임을 표시하도록 했습니다. 과학기술정보통신부 가이드라인은 결과물을 다운로드나 공유로 서비스 밖에 내보낼 때 사람이 알아볼 수 있는 워터마크를 넣거나, 안내 문구와 메타데이터 같은 기계 판독 표시를 함께 쓰도록 했습니다. 의무를 지는 쪽은 AI 서비스를 제공하는 사업자이고, 업무나 창작에 AI를 도구로 쓰는 이용자는 제외됩니다(아시아경제). 과태료 부과는 최소 1년 유예됩니다. 중국은 2025년 9월 1일부터 텍스트를 포함한 AI 생성 콘텐츠에 눈에 보이는 표시와 파일 메타데이터 속 표시를 함께 넣도록 했습니다.
워터마크가 있으면 구글 순위가 떨어질까요?
공개된 근거로는 그렇지 않습니다. 구글은 2023년 2월 AI 생성 콘텐츠 지침에서 콘텐츠를 어떻게 만들었는지가 아니라 품질을 보상한다고 밝혔고, 이 입장을 바꾼 적이 없습니다. 구글이 문제로 삼는 것은 검색 순위를 조작할 목적으로 자동화를 쓰는 경우입니다. 스팸 정책의 대량 생산 콘텐츠 남용 항목은 사용자에게 가치를 더하지 않고 생성형 AI로 많은 페이지를 만드는 것을 예로 들면서, 만든 방식과 관계없이 적용된다고 적었습니다.
구글이 텍스트 워터마크를 순위 신호로 쓴다고 밝힌 적도 없습니다. 구글은 2024년부터 제미나이 텍스트에 SynthID 워터마크를 넣어 왔지만, 검색에 SynthID를 붙인 기능으로 발표한 것은 렌즈, AI 모드, 서클 투 서치에서 이미지가 AI로 만들어졌는지 확인해 주는 기능입니다(2026년 5월). 기술적으로도 구글이 확인할 수 있는 것은 자사 키로 넣은 워터마크이고, Anthropic과 OpenAI의 워터마크는 각 회사의 키가 있어야 확인할 수 있습니다.
워터마크가 글의 품질을 바꾸지도 않습니다. 구글 딥마인드의 2,000만 건 비교에서도, OpenAI가 공개한 벤치마크 비교에서도 워터마크 유무에 따른 의미 있는 차이는 나오지 않았습니다. Anthropic은 읽는 사람이 워터마크가 든 글과 없는 글을 구별할 수 없다고 밝혔습니다.
검색 노출을 가르는 것은 워터마크가 아니라 글을 만드는 과정입니다. 구글은 생성형 AI 콘텐츠 안내에서 생성형 모델은 사실을 찾아오는 것이 아니라 그럴듯한 단어를 예측하므로, 게시 전에 정확성을 직접 확인하고 검토하라고 권합니다. 제목, 메타 설명, 구조화 데이터, 이미지 대체 텍스트도 검토 대상입니다. 워터마크를 지우려고 단어를 기계적으로 바꾸는 방식은 오히려 위험합니다. 구글은 다른 콘텐츠를 동의어 치환 같은 자동 변형으로 바꿔 많은 페이지를 만드는 것을 대량 생산 콘텐츠 남용의 예로 들고 있습니다.
AI 검색 인용(GEO)에서도 워터마크 기준은 공개된 것이 없습니다
GEO(생성형 엔진 최적화)는 ChatGPT, 퍼플렉시티, 구글 AI 개요 같은 AI 검색의 답변에 출처로 인용되도록 콘텐츠를 다듬는 일입니다. 2026년 10월 현재 이들 서비스 가운데 답변 출처를 고를 때 워터마크를 확인한다고 밝힌 곳은 없습니다. 구글은 AI 기능 안내 문서에서 AI 개요와 AI 모드에 나오기 위한 별도 요건은 없고, 일반 검색에 색인되어 스니펫으로 보일 수 있는 페이지면 된다고 안내합니다.
현실적인 제약도 있습니다. AI 검색 서비스가 다른 회사의 워터마크를 확인하려면 그 회사의 검출기를 거쳐야 하는데, 지금은 검출기가 연구 기관과 규제 기관 위주로만 열려 있습니다. EU 실천 강령이 요구하는 검출기 상호 운용성이 2027년 2월 이후 갖춰지면 플랫폼이 여러 회사의 워터마크를 한 번에 확인할 수 있게 됩니다. 그 결과를 어디에 쓸지는 아직 어느 검색 서비스도 밝히지 않았습니다.
AI 검색에서 인용 여부를 가르는 것은 결국 글의 내용입니다. 프린스턴대 등 연구진이 2024년 발표한 GEO 연구에서는 신뢰할 수 있는 출처 인용, 관련 인용문, 통계 수치를 더한 글의 노출이 여러 질의에서 40% 넘게 늘었고, 실제 서비스인 퍼플렉시티에서도 최대 37% 늘었습니다. 출처로 확인된 사실과 수치를 갖춘 글이 인용에 유리하다는 결과입니다.
자주 하는 오해
- “워터마크가 있는 글은 구글이 순위를 낮춘다” 구글은 만든 방식이 아니라 품질을 본다는 입장이고, 텍스트 워터마크를 순위에 쓴다고 밝힌 적이 없습니다. 문제가 되는 것은 가치를 더하지 않고 대량으로 만든 페이지입니다.
- “숨은 문자를 지우면 워터마크가 사라진다” 통계적 워터마크는 단어 선택에 남습니다. 구글, Anthropic, OpenAI가 쓰는 방식은 숨은 문자를 넣지 않습니다.
- “워터마크가 검출되지 않으면 사람이 쓴 글이다” 짧은 글, 많이 고친 글, 번역한 글, 워터마크를 넣지 않는 모델로 만든 글은 검출되지 않습니다. OpenAI도 미검출이 사람이 썼다는 증거는 아니라고 밝혔습니다.
- “AI 탐지기로 워터마크를 확인할 수 있다” 시중 AI 탐지기는 키가 없어 문체와 단어 빈도로 추정합니다. 워터마크는 키를 가진 회사의 검출기로만 확인할 수 있습니다.
- “워터마크로 누가 썼는지 추적된다” Anthropic과 OpenAI는 워터마크에 사용자, 조직, 대화 정보가 들어가지 않는다고 밝혔습니다. 다만 키를 어떻게 관리하는지 외부에서 검증할 방법은 아직 없다는 지적이 학계에서 나옵니다.
확인할 항목
- 쓰는 AI의 적용 범위. 클로드(전 세계), 제미나이 앱, EU 지역 ChatGPT처럼 워터마크가 들어가는 도구인지 확인합니다.
- 사람의 검토 기록. 누가 어떤 내용을 확인했는지 남깁니다. EU 독자를 대상으로 공익 주제 글을 게시한다면 실질적인 검토와 책임자 표시가 있어야 AI 표시 의무의 예외가 됩니다.
- 사실 확인. 수치, 날짜, 인용을 1차 자료로 확인합니다. 제목, 메타 설명, 구조화 데이터도 포함합니다.
- 그 페이지에만 있는 정보. 직접 측정한 데이터, 실제 사례, 현장 경험, 공식 문서 확인 결과처럼 AI 초안에 없던 내용을 더합니다.
- 대량 생산 여부. 같은 틀에 지역명이나 키워드만 바꾼 페이지를 많이 만들고 있지 않은지 점검합니다.
- 워터마크 제거 도구. 특수 문자 제거 도구는 통계적 워터마크와 관계가 없고, 동의어 치환 도구는 구글 스팸 정책이 예로 든 자동 변형과 같은 방식입니다.
워터마크는 AI가 관여했다는 신호일 뿐 품질 평가가 아닙니다
텍스트 워터마크는 AI가 글에 관여했을 가능성을 키를 가진 쪽이 확인할 수 있게 하는 표시입니다. 글이 좋은지, 사람이 얼마나 손봤는지, 내용이 맞는지는 알려 주지 않습니다. 2026년 10월 현재 구글 검색이나 AI 검색이 이 표시를 노출 기준으로 쓴다는 공식 근거는 없습니다. 검색 성과와 규제 대응에서 함께 따져 볼 것은 워터마크 유무가 아니라 AI 초안에 사람이 무엇을 확인하고 더했는지입니다.
자주 묻는 질문
Q. AI 텍스트 워터마크란 무엇인가요?
Q. 클로드로 쓴 글에는 워터마크가 들어가나요?
Q. ChatGPT나 제미나이로 쓴 글에도 워터마크가 있나요?
Q. 워터마크가 있는 글은 구글 검색 순위가 떨어지나요?
Q. 내 글에 워터마크가 있는지 확인할 수 있나요?
Q. 글을 고치면 워터마크가 사라지나요?
참고 자료
아래는 본문 서술의 바탕이 된 공개 자료입니다.
- Nature — Scalable watermarking for identifying large language model outputs(SynthID-Text, 2024년 10월)
- Anthropic — How Claude’s text watermarking works(2026년 8월)
- OpenAI — Our approach to EU text provenance rules(2026년 10월)
- European Commission — Code of Practice on Transparency of AI-generated Content
- Google 검색 센터 — Google Search’s guidance about AI-generated content(2023년 2월)