3줄 요약
- 중복 콘텐츠 자체에 매기는 벌점은 없다. 구글·Bing·네이버 모두 비슷한 문서를 한 묶음으로 보고 그중 대표 문서 하나를 골라 보여 준다.
- 손해는 다른 데서 생긴다. 원하지 않는 주소가 대표로 뽑히거나, 링크 같은 평가 신호가 여러 주소로 나뉘거나, 크롤링이 낭비된다. AI 검색에서는 원본 대신 복제본이 출처로 달릴 수 있다.
- 남의 글을 베끼거나 단어만 바꿔 대량으로 올리는 것은 중복이 아니라 스팸 정책 위반이다. 벌점이 없다는 말과 영향이 없다는 말은 다르다.
홈페이지에 쓴 글을 네이버 블로그에도 올리고, 보도자료를 여러 매체에 내보내고, 상품 목록을 정렬·필터별 주소로 열어 두는 일은 대부분의 회사가 늘 한다. 그럴 때마다 “이러다 검색에서 벌점 받는 거 아니에요?”라는 질문이 나온다. 구글·네이버·Bing이 공식 문서에 적어 둔 내용을 기준으로 답을 정리했다.
중복 콘텐츠란?
중복 콘텐츠(duplicate content)는 같은 내용이 서로 다른 URL에 있는 상태를 말한다. 구글 SEO 기본 가이드는 같은 콘텐츠를 여러 URL로 보여 주는 것을 중복 콘텐츠라고 부르고, 검색엔진은 콘텐츠마다 사용자에게 보여 줄 URL 하나(대표 URL, canonical URL)를 고른다고 설명한다. 정의 어디에도 처벌 이야기는 없다.
완전히 같지 않아도 중복이다
구글은 2006년 12월 글에서 중복 콘텐츠를 도메인 안이나 도메인 사이에서 다른 콘텐츠와 완전히 일치하거나 상당히 비슷한 본문 덩어리라고 정의했다. 한 글자도 다르지 않아야 중복인 게 아니다. 상당히 비슷하면 같은 묶음으로 취급될 수 있다.
네이버는 유사문서라고 부른다
네이버 검색 공식블로그는 2016년 12월 글에서 유사문서를 “문서에 포함된 제목과 본문 텍스트, 그리고 사진과 동영상 등 구성 요소가 서로 닮은 문서”라고 정의하고, 완벽하게 일치하지 않아도 일정 수준 이상 비슷하면 유사문서라고 했다(원문). 글자뿐 아니라 사진과 동영상까지 비교한다.
중복이라는 말에 섞여 있는 세 가지
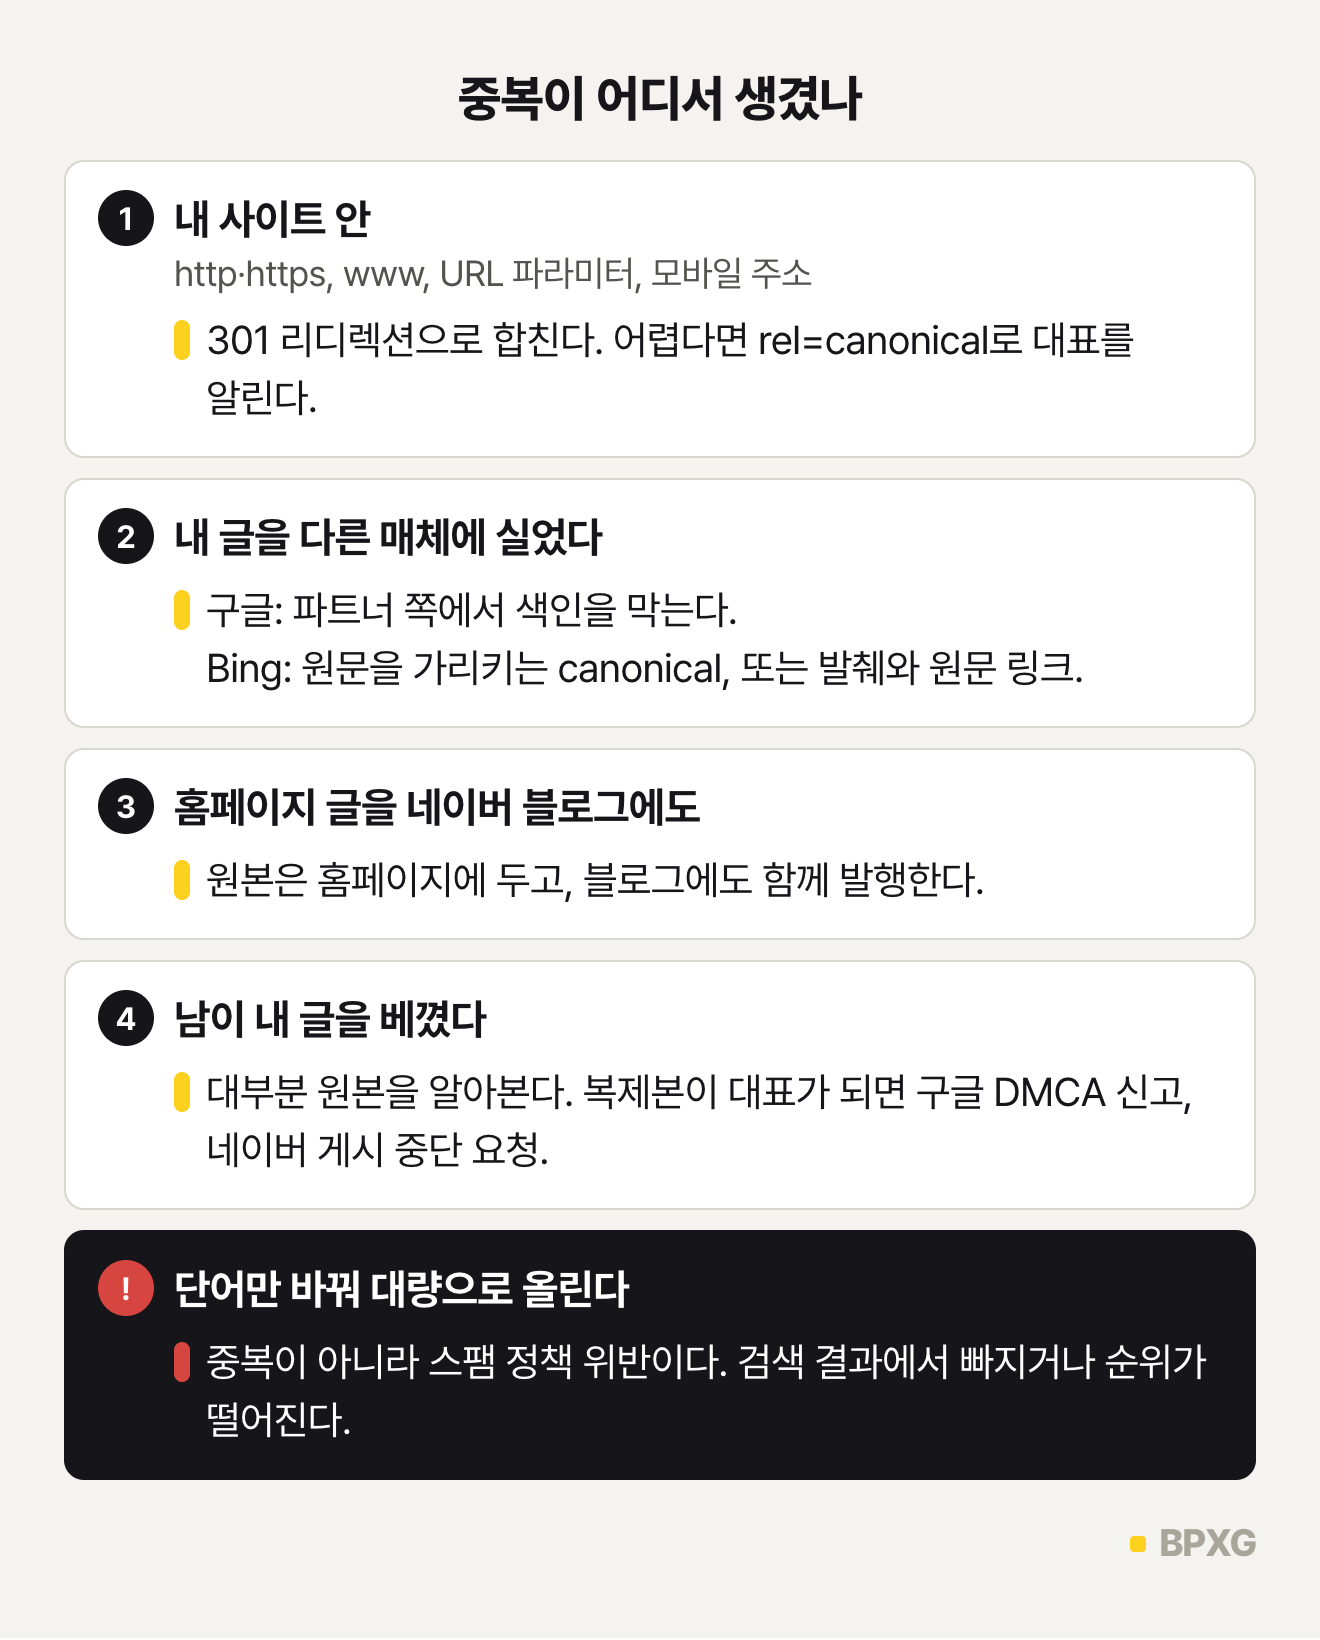
실무에서 중복이라고 부르는 것에는 성격이 전혀 다른 세 가지가 섞여 있다. 구글 정규화(canonicalization) 문서는 사이트 안에서 흔히 생기는 중복으로 지역 변형, 모바일·데스크톱 같은 기기 변형, HTTP·HTTPS 같은 프로토콜 변형, 정렬·필터 결과 페이지, 실수로 공개된 데모 버전을 든다.
| 구분 | 예시 | 성격 |
|---|---|---|
| 사이트 안의 기술적 중복 | http·https 혼재, www 유무, URL 파라미터·정렬·필터 결과, 모바일 전용 URL, 같은 언어의 지역 변형, 실수로 열린 데모 버전 | 정상 범위다. 구글은 사이트 안에 어느 정도 중복이 있는 건 정상이고 스팸 정책 위반이 아니라고 적었다. 정규화로 관리하면 된다. |
| 사이트 밖 중복 | 보도자료 전재, 매체와의 신디케이션(syndication) 계약, 같은 글을 홈페이지·블로그·외부 채널에 함께 게시 | 그 자체로 정책 위반은 아니다. 어느 쪽이 대표로 뽑힐지 내가 정하기 어렵고, 검색엔진마다 권고가 다르다. 노출을 늘리려고 같은 콘텐츠로 사이트를 여러 개 만드는 것은 네이버가 불이익을 경고한다. |
| 복제·조작 | 남의 글 스크래핑, 유의어 치환·자동 변형, 문장 일부만 바꾼 페이지 대량 발행 | 스팸 정책에 걸리는 건 여기다. 검색 결과에서 빠지거나 순위가 떨어진다. |
번역 페이지는 중복이 아니다. 구글 현지화 버전 문서는 본문을 번역하지 않고 그대로 둔 경우에만 현지화 페이지를 중복으로 본다고 적었다. 영문 사이트를 한국어로 제대로 번역했다면 별개의 문서다.
검색엔진이 중복 문서를 처리하는 방식
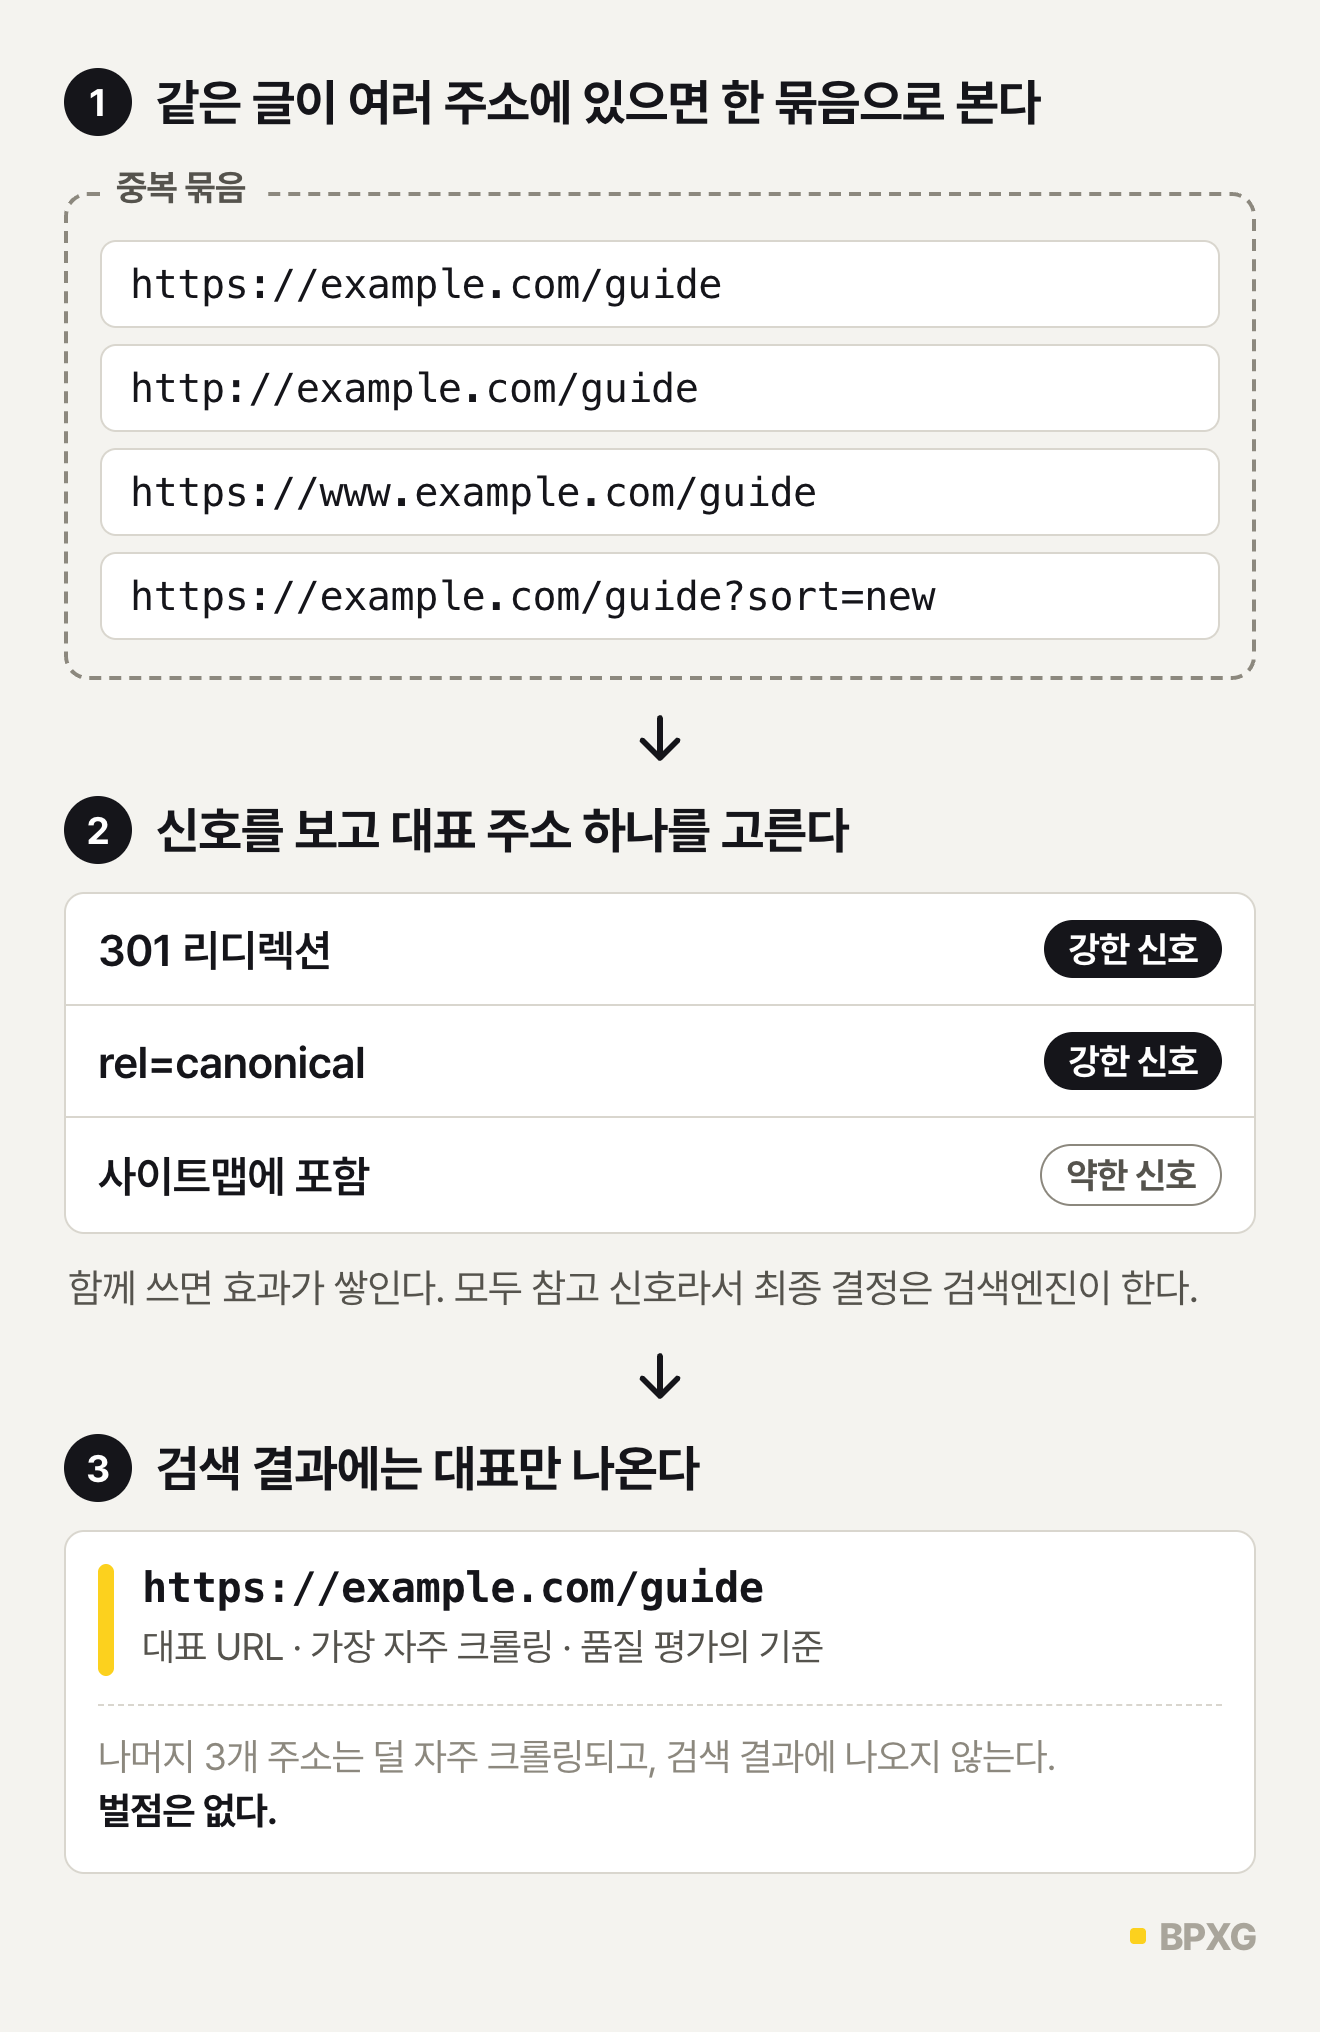
검색엔진은 비슷한 문서를 묶고, 그중 대표를 골라 대표만 보여 준다. 벌을 주는 절차가 아니라 고르는 절차다. 구글 정규화 문서는 같거나 주요 내용이 매우 비슷한 페이지들을 하나로 묶는다고 설명하고, 이 과정을 중복 제거(deduplication)라고 부른다. 검색 결과에는 그중 한 버전만 나온다.
구글은 대표 페이지를 기준으로 평가한다
묶음이 생기면 세 가지가 달라진다. 대표 페이지는 가장 자주 크롤링되고 나머지는 덜 자주 크롤링된다. 콘텐츠와 품질도 대표 페이지를 기준으로 평가한다. 그리고 사이트 운영자가 지정한 canonical은 지시가 아니라 참고 신호다. 구글은 이를 “a hint, not a rule”(규칙이 아니라 힌트)이라고 적었고, 2009년 canonical 태그를 처음 발표할 때도 강하게 존중하는 힌트라고 했다.
신호마다 세기도 다르다. 중복 URL 통합 문서는 리디렉션과 rel=canonical을 강한 신호로, 사이트맵에 넣는 것을 약한 신호로 분류하고, 여러 방법을 함께 쓰면 효과가 쌓인다고 적었다. 그러면서 어느 것도 필수는 아니고, 대표를 따로 지정하지 않아도 사이트는 대체로 문제없을 거라고 했다. 페이지가 많지 않은 사이트라면 canonical이 빠졌다고 큰일이 나지 않는다.
서치 콘솔에 ‘Duplicate without user-selected canonical'(사용자가 대표를 지정하지 않은 중복)이 떠도 오류가 아니다. 구글 도움말은 중복 페이지를 노출하지 않으니 의도대로 작동하는 상태라고 설명한다. 반면 ‘Duplicate, Google chose different canonical than user'(구글이 사용자와 다른 대표를 고름)가 반복된다면 내가 고른 대표가 받아들여지지 않고 있다는 뜻이다.
네이버의 유사문서 판독 시스템
네이버는 유사문서 판독 시스템으로 원본과 복사본을 가린다. 공식블로그는 이 시스템으로 기본 검색 결과에서 원본 문서가 먼저 노출되게 한다고 밝혔고, 2018년 10월 글에서는 블로그·카페 등 UGC 검색 전반에 원본글과 복사글(유사문서)을 구분해 보여 주는 시스템을 쓴다고 설명했다. 블로그와 포스트에 같은 글을 올린 경우에는 먼저 작성한 글을 원본으로 본다고 답했다(2017년 1월).
한 번 내린 판정이 그대로 굳는 것도 아니다. 유사문서로 판정된 글도 주기적으로 다시 판독한다. 2025년 2월 글에 따르면 판독 속도가 빨라져 검색에 반영되는 시점도 앞당겨졌고, UGC 검색에는 C-Rank, D.I.A.+와 함께 유사문서 판독 시스템이 적용된다. 노출 원칙도 공개했다. 네이버는 ‘통합 웹’이나 ‘리뷰’ 같은 동일한 영역에서 유사한 문서 두 개가 동시에 노출되지 않는 게 좋다고 판단했다고 밝혔다.
웹사이트 쪽 권고는 서치어드바이저에 있다. 똑같은 내용은 중복 판정을 받는다고 전제하고, 여러 주소를 꼭 써야 한다면 대표 주소로 301 리디렉션을 하고, 그게 어렵다면 rel=”canonical”로 대표 주소를 적으라고 안내한다. 그러면서도 FAQ에서는 사이트 운영자가 설정하지 않은 URL이 대표로 뽑힐 수 있고 canonical은 ‘참고 정보’라고 적었다. 구글이 canonical을 힌트라고 부르는 것과 같은 얘기다.
Bing은 신호가 흐려진다고 본다
Bing 웹마스터 가이드라인은 중복 URL이 신호를 흐리고, 답변의 근거(그라운딩)나 인용에 쓸 URL을 고를 때 Bing의 확신을 떨어뜨린다고 적었다. canonical 태그는 선호를 알리는 데 도움이 되지만 근본 문제를 고치는 일을 대신하지는 못한다고도 했다. 세 검색엔진 모두 중복을 처벌이 아니라 선택과 희석의 문제로 설명한다.
SEO에서 실제로 잃는 것
벌점은 없다. 구글은 2008년 9월 글에서 “There’s no such thing as a ‘duplicate content penalty.'”라고 썼다. 사람들이 흔히 생각하는 의미의 중복 콘텐츠 페널티는 없다는 뜻이다. 조치가 들어가는 건 속이거나 순위를 조작하려는 의도가 있을 때다. SEO 기본 가이드도 같은 내용이 여러 URL에 있는 건 비효율적일 뿐 수동 조치를 부르지 않는다고 하면서, 남의 콘텐츠를 베끼는 것은 다른 문제라고 덧붙였다.
원하지 않는 주소가 대표가 된다
구글 2006년 글은 대부분의 경우 사이트 운영자가 겪는 최악의 결과가 ‘덜 원하는’ 버전이 색인에 보이는 정도라고 적었다. 파라미터가 붙은 URL이나 잠깐 열어 둔 테스트 페이지가 대표가 되는 식이다. 드물게는 더 나쁜 경우도 있다. 정규화 문제 해결 문서는 허락 없이 내 콘텐츠를 올린 외부 사이트의 URL이 대표로 뽑힐 수 있다며, 이때는 DMCA 신고를 하라고 안내한다.
평가 신호가 나뉜다
구글 2008년 글은 검색엔진이 중복을 다 찾아내지 못하면 랭킹 신호가 여러 URL로 나뉘어 약해질 수 있다고 설명한다. 외부에서 받은 링크가 여러 주소로 흩어지면 어느 주소도 충분히 힘을 받지 못한다. 벌점은 없어도 손해는 있다는 말이 이런 경우다.
크롤링이 낭비된다
구글 크롤링 예산 가이드는 중복 URL이 많으면 구글이 그 사이트를 크롤링하는 시간을 크게 낭비한다고 적었다. 다만 이 가이드는 페이지가 수만에서 수백만 개에 이르는 대형 사이트를 위한 문서다. 페이지가 수백 개인 회사 사이트라면 크롤링 예산보다 앞의 두 가지가 더 현실적인 문제다.
의도적인 복제는 스팸이다
베끼는 건 중복과 다른 문제다. 구글 스팸 정책은 다른 사이트의 콘텐츠를 복사해 유의어 치환이나 자동화 기법으로 조금만 고쳐 다시 올리는 것을 스크래핑으로 정의하고, 대규모 콘텐츠 남용에도 유의어 바꾸기나 번역 같은 자동 변형을 포함시켰다. 네이버 웹 콘텐츠 스팸 사례(2026년 7월)도 문장 일부만 바꾼 페이지를 수십 개 이상 발행하는 방식을 스크래핑으로 보고, 특정 기술을 썼는지만으로 판단하지는 않는다고 적었다. 걸리면 검색 결과에서 빠지거나 순위가 떨어진다. Bing 가이드라인도 새로운 통찰이나 관점 없이 기존 콘텐츠를 고치거나 가볍게 다시 쓴 것을 스크래핑으로 본다. 템플릿으로 페이지를 대량으로 만드는 방식이 위험해지는 것도 이 지점이다.
사이트를 여러 개 운영할 때도 조심해야 한다. 네이버 서치어드바이저는 검색 노출을 늘리려고 같은 콘텐츠로 사이트를 여러 개 만들면 노출에 불이익을 받을 수 있다고 경고한다. 중복이 곧 벌점이라는 말도, 중복은 아무 상관 없다는 말도 틀렸다. 기술적 중복은 관리하면 되는 일이고, 의도적인 복제는 정책 위반이다.
AI 검색(GEO)에서 잃는 것
AI 답변이 내 원본 대신 복제본을 출처로 고를 수 있다. 공식 문서 가운데 이 문제를 가장 자세히 다룬 곳은 Bing이다. Bing 웹마스터 블로그(2025년 12월)는 중복 콘텐츠가 그 자체로 검색 페널티를 부르지는 않지만, 권위를 흐리고 의도를 헷갈리게 하며 수정한 내용이 검색엔진과 AI 기반 발견 시스템에 반영되는 속도를 늦춰 노출을 떨어뜨린다고 적었다.
LLM도 묶어서 하나를 고른다
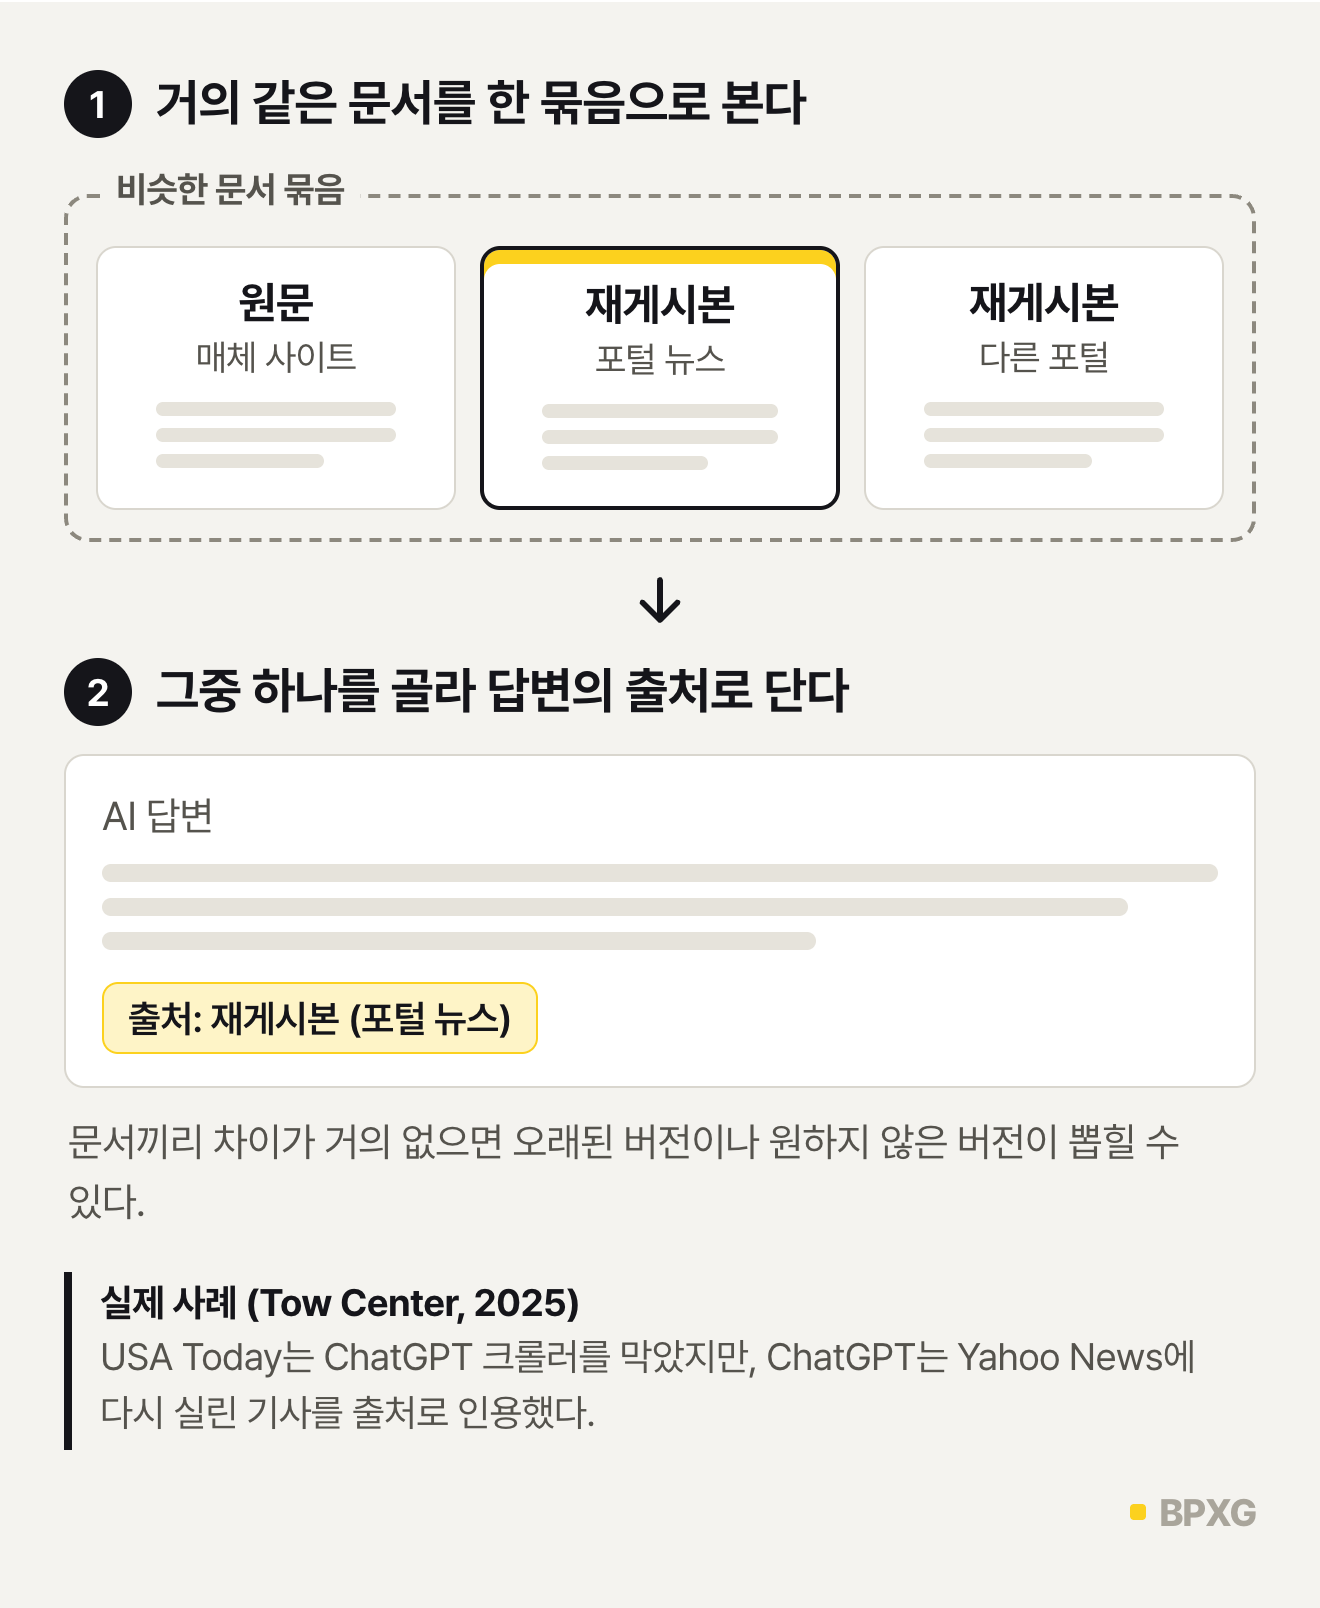
같은 글에 따르면 LLM은 거의 같은 URL들을 한 묶음으로 보고 그중 한 페이지를 대표로 고른다. 페이지끼리 차이가 거의 없으면 오래된 버전이나 내가 내세우려던 것과 다른 버전을 고를 수 있고, 그만큼 내가 원하는 페이지가 답변의 근거로 뽑힐 가능성이 낮아진다. Microsoft의 설명이고, 이를 뒷받침하는 실험 데이터는 공개되지 않았다.
구글은 AI 기능과 중복을 직접 연결하지 않았다
구글 AI 기능 문서는 AI 개요나 AI 모드에 참조 링크로 나오려면 페이지가 색인돼 있고 스니펫과 함께 구글 검색에 표시될 자격이 있어야 하며, 그 밖의 기술 요건은 없다고 적었다. 서치 콘솔 도움말은 대표로 뽑히지 않은 중복 URL은 검색에 제공하지 않는다고 설명한다. 두 문서를 같이 놓고 보면 대표로 뽑히지 않은 URL은 AI 개요·AI 모드의 링크 후보가 되기 어렵다고 추론할 수 있다. 구글이 AI 기능에 대해 직접 그렇게 쓴 것은 아니다.
구글이 중복을 직접 언급한 곳은 생성형 AI 기능 최적화 가이드다. 중복 콘텐츠는 사용자 경험을 해칠 수 있고 검색엔진이 신경 쓰지 않아도 될 URL에 크롤링 자원을 쓰게 만들 수 있으니, 시간이 있으면 줄여 보라고 적었다. ‘시간이 있으면’이라는 표현대로 우선순위가 높은 일로 다루지는 않는다.
같은 가이드에는 반대쪽 경고도 있다. 사람들이 검색할 만한 변형마다 페이지를 따로 만드는 것이 주로 순위나 생성형 AI 응답을 조작하려는 목적이라면 대규모 콘텐츠 남용 정책 위반이라고 했다. 생성형 AI 검색만을 위해 특별한 방식으로 쓸 필요는 없고, 남들이 이미 한 말을 재활용하지 말라고도 했다. GEO의 기본이 결국 SEO라는 이야기와 같은 결론이다.
복제본이 인용된 사례
컬럼비아대 Tow Center는 2025년 3월 공개한 조사에서 AI 검색 8종(ChatGPT Search, Perplexity, Perplexity Pro, DeepSeek Search, Copilot, Grok-2, Grok-3, Gemini)에 매체 20곳의 기사 10건씩, 모두 1,600번 질의해 기사 발췌문의 원문·매체·날짜·URL을 찾게 했다. 챗봇이 원문 대신 Yahoo News나 AOL에 실린 신디케이션 버전으로 안내한 경우가 있었고, AI 기업과 라이선스 계약을 맺은 매체도 예외가 아니었다. Perplexity Pro는 제휴 매체 기사 10건 가운데 3건에서 신디케이션본을 인용했다. 크롤러를 막아도 완전히 피하지는 못했다. USA Today는 ChatGPT 크롤러를 차단했지만 ChatGPT는 Yahoo News에 다시 실린 기사를 인용했다.
2024년 11월 조사에서는 ChatGPT search가 NYT 기사를 출처 표시 없이 통째로 베낀 사이트를 인용한 사례가 나왔다. OpenAI는 이 조사가 자사 제품을 일반적이지 않은 방식으로 시험한 것이라고 반박했다. 두 조사 모두 비율을 낸 통계가 아니라 사례를 모은 관찰이다.
네이버 블로그는 AI 봇을 막는다
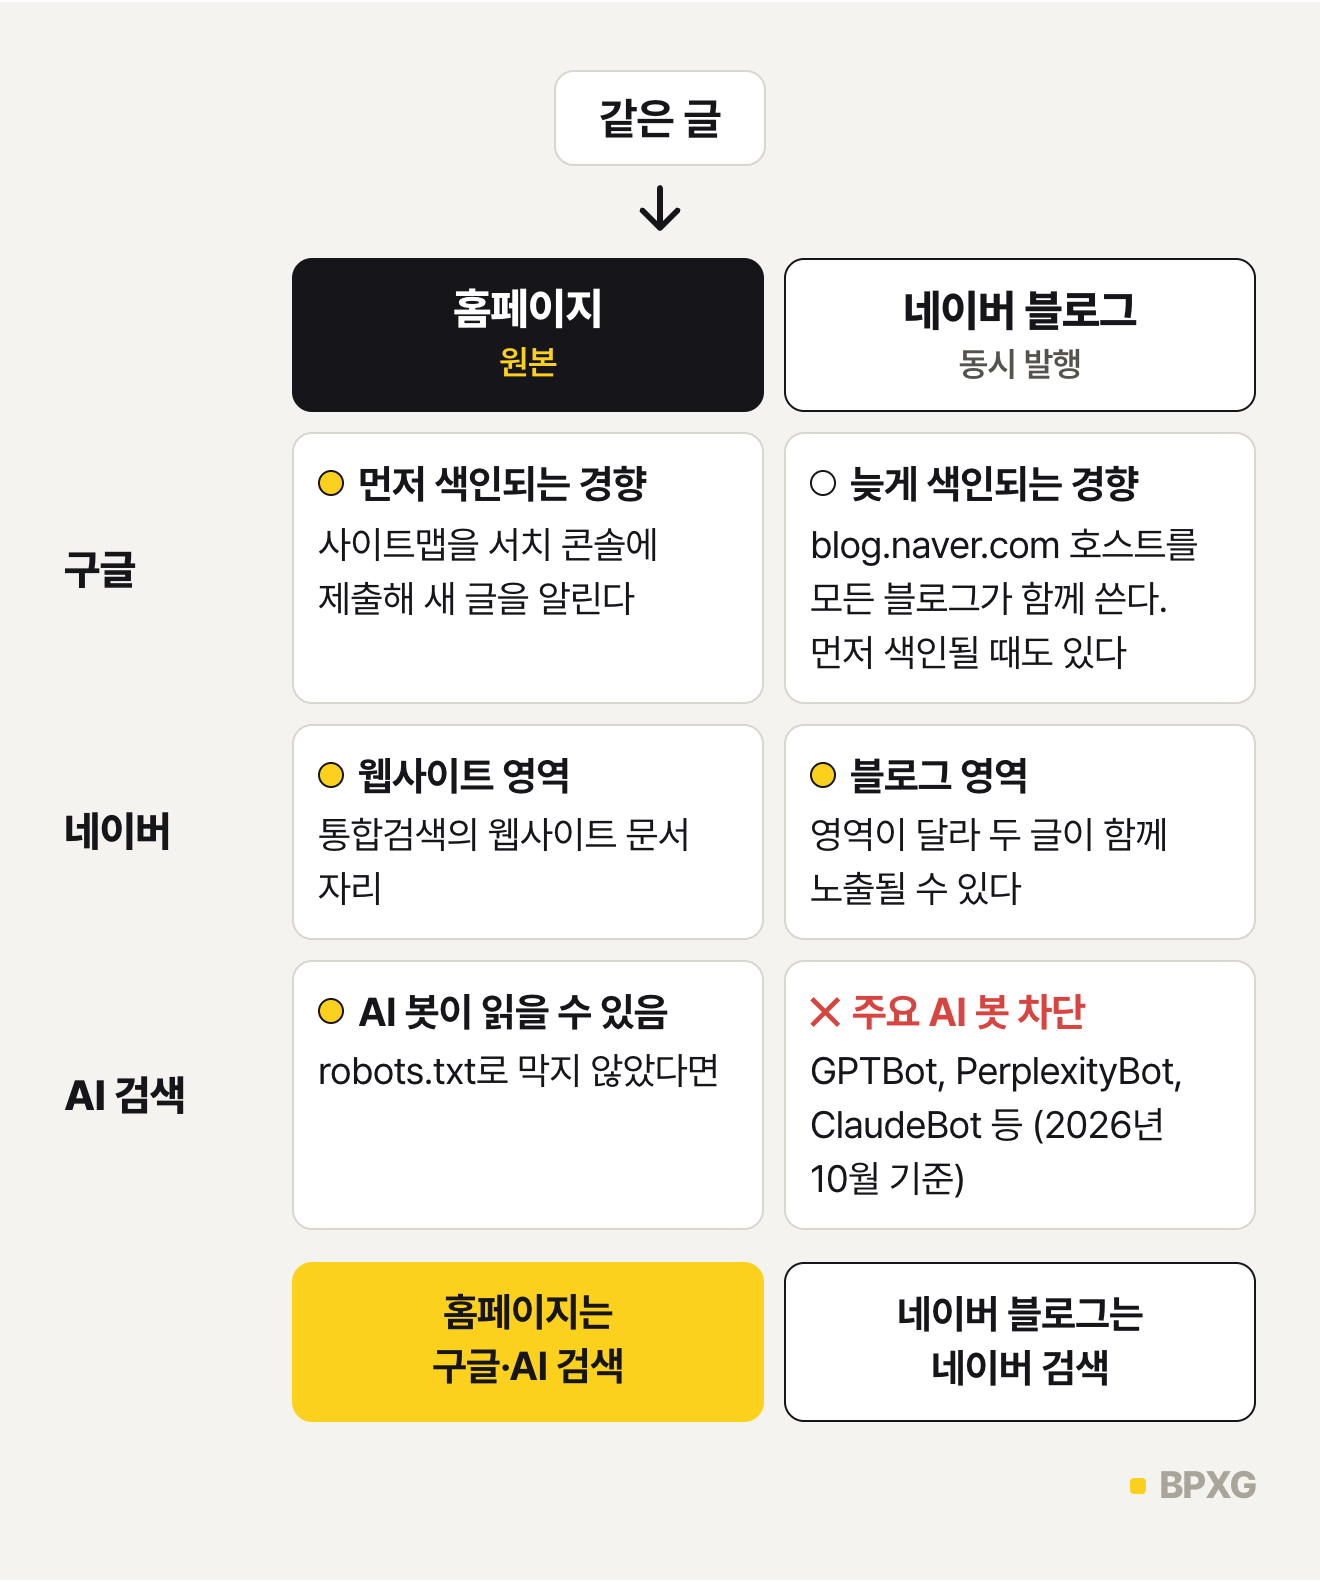
국내에서는 조건이 하나 더 있다. 2026년 10월 4일 기준 네이버 블로그 robots.txt는 GPTBot, OAI-SearchBot, PerplexityBot, Google-Extended, ClaudeBot, Claude-SearchBot, CCBot 등 주요 AI 봇을 모두 막고 있고, Googlebot은 막지 않는다. 네이버 블로그에만 있는 글은 외부 AI 봇이 직접 읽어 가기 어렵다는 뜻이다.
중복 때문에 AI 답변 인용이 몇 퍼센트 줄어든다는 공개 연구는 아직 없다. 지금 있는 건 Bing의 공식 설명, 구글 문서를 엮은 추론, 언론 조사의 사례다.
중복 콘텐츠에 대한 흔한 오해 12가지
자주 듣는 말과 공식 문서의 내용을 나란히 놓았다.
| 오해 | 실제 | 근거 |
|---|---|---|
| 중복 콘텐츠 페널티가 있다 | 세 검색엔진 모두 부정한다. 구글은 그런 페널티는 없다고, Bing은 중복 자체가 페널티를 부르지 않는다고 적었다. | 구글 2008년 블로그·정규화 문서, Bing 2025년 12월 블로그 |
| 그러니 중복은 신경 쓸 필요 없다 | 신호 분산, 크롤링 낭비, 원하지 않는 버전 노출은 실제로 생긴다. | 구글 2006·2008년 블로그, 크롤링 예산 가이드 |
| canonical을 넣으면 그대로 따른다 | 구글은 규칙이 아니라 힌트라고 한다. 네이버도 canonical을 ‘참고 정보’라 하고 대표 URL은 검색엔진이 정한다고 적었다. | 구글 정규화 문서, 네이버 서치어드바이저 FAQ |
| robots.txt로 막으면 중복이 해결된다 | 구글은 정규화 목적으로 robots.txt를 쓰지 말라고 한다. 2009년에 바뀐 권고다. 대형 사이트가 크롤링 양을 관리하려고 막는 경우는 예외다. | 구글 중복 URL 통합 문서, 2009년 10월 블로그 |
| noindex가 canonical보다 확실하다 | 사이트 안에서는 권하지 않는다. 페이지가 검색에서 아예 빠지기 때문이다. 구글은 rel=canonical을 우선 권한다. | 구글 중복 URL 통합 문서 |
| 번역 페이지는 중복이다 | 본문을 번역하지 않고 둔 경우에만 중복이다. | 구글 현지화 버전 문서 |
| 신디케이션은 canonical 하나로 해결된다 | 검색엔진마다 다르다. 구글은 canonical 대신 파트너 쪽에서 색인을 막으라고 권하고, Bing은 파트너 쪽 canonical이나 발췌 게재를 권한다. | 구글 정규화 문제 해결 문서, Bing 2025년 12월 블로그 |
| 누가 내 글을 베끼면 내가 불이익을 받는다 | 구글은 대부분 원본을 제대로 알아봐서 원본에 나쁜 영향이 없다고 했다. 네이버도 유사문서 공격으로 내 글이 유사문서 처리돼도 검색 랭킹에 영향을 주지 않는다고 밝혔다. 드물게 외부 사이트가 대표로 뽑히면 DMCA 신고를 한다. | 구글 2008년 6월 블로그·정규화 문제 해결 문서, 네이버 2016년 11월 |
| 유의어로 바꾸거나 AI로 고쳐 쓰면 중복이 아니다 | 그게 바로 스팸 정책이 말하는 스크래핑·대규모 콘텐츠 남용이다. 네이버 유사문서 정의도 완벽하게 같지 않아도 일정 수준 이상 비슷한 경우를 포함한다. | 구글 스팸 정책, Bing 가이드라인, 네이버 2016년 12월·2026년 7월 |
| 유사문서 판정을 받으면 블로그가 ‘저품질’에 빠진다 | 네이버는 저품질 블로그라는 개념은 없다고 했다. 블로그를 오래 관리하지 않으면 C-Rank가 떨어질 수 있지만 다시 꾸준히 관리하면 오른다고 설명했다. 어뷰징이 심했던 문서는 지워도 페널티 이력이 오래 영향을 줄 수 있다. | 네이버 2016년 7월, 2019년 6월 |
| AI 검색용으로 검색어 변형마다 페이지를 만들어야 한다 | 순위나 AI 응답 조작이 주목적이면 대규모 콘텐츠 남용 정책 위반이라고 구글이 명시했다. | 구글 생성형 AI 최적화 가이드 |
| 네이버는 canonical을 무시한다 | 무시하지 않는다. 301 리디렉션을 먼저 권하고, 어렵다면 rel=canonical을 쓰라고 안내한다. 최종 대표 URL은 검색엔진이 정한다. | 네이버 서치어드바이저 가이드·FAQ |
같은 글을 홈페이지와 네이버 블로그에 올려도 될까요?
중복을 어느 정도 감수하더라도 네이버 블로그에 함께 발행해야 한다. 네이버 검색에서 노출되려면 네이버 블로그가 필요하고, 구글에서는 이 정도 중복을 크게 걱정하지 않아도 되기 때문이다.
네이버에서는 블로그와 웹사이트가 따로 노출된다
네이버는 자사 서비스 안(블로그·포스트)에 같은 글이 있으면 먼저 쓴 글을 원본으로 본다고 밝혔지만, 네이버 블로그와 외부 웹사이트 사이의 원본 판정 기준을 공개한 자료는 찾지 못했다. 서치어드바이저 FAQ가 중복 문서가 다른 주소로 반영됐을 수 있으니 다른 URL이나 통합검색의 다른 검색 DB에 문서가 실려 있는지 확인해 보라고 안내하는 정도다.
네이버 통합검색은 블로그 글과 웹사이트 문서를 서로 다른 영역에 나눠 보여 준다. 네이버가 유사한 문서 두 개를 함께 보여 주지 않겠다고 한 것은 같은 영역 안의 이야기라서, 같은 글이라도 블로그 영역과 웹사이트 영역에 각각 노출될 수 있다. 홈페이지에만 글을 올리면 네이버에서는 웹사이트 영역 하나만 노리게 된다.
구글에서는 크게 걱정하지 않아도 된다
구글은 중복 콘텐츠에 벌점을 매기지 않는다. 같은 글이 홈페이지와 블로그에 있으면 둘을 묶어 하나를 대표로 보여 줄 뿐이다. 실무에서는 홈페이지 글이 구글에 먼저 색인되고 네이버 블로그 글은 늦게 색인되는 경향이 있다. 이유는 두 가지다.
- 사이트맵. 홈페이지는 사이트맵을 만들어 서치 콘솔에 제출할 수 있다. 구글 사이트맵 문서는 사이트맵이 검색엔진의 URL 발견을 돕는다고 설명한다. 새 글 주소를 구글에 직접 알릴 수 있는 셈이다. 네이버 블로그 글은 구글이 블로그를 크롤링하다 찾아내기를 기다리는 경우가 많다.
- 크롤링 예산. 구글 크롤링 예산 가이드에 따르면 구글은 크롤링 자원을 사이트 단위로 나누고, 사이트를 호스트 이름으로 구분한다. blog.naver.com은 수많은 블로그가 같은 호스트 이름을 함께 쓰는 곳이라, 내 블로그의 새 글 하나가 구글 크롤러의 차례를 빨리 받는다는 보장이 없다.
늘 홈페이지가 먼저인 것은 아니다. 네이버 블로그 글이 홈페이지보다 먼저 색인되는 경우도 생긴다. 이때도 벌점은 없고, 어느 주소가 대표로 뽑히느냐의 문제로 남는다.
AI 검색은 홈페이지가 맡는다
외부 AI 봇이 읽을 수 있는 쪽은 홈페이지다. 네이버 블로그는 주요 AI 봇을 막고 있어서 블로그에만 있는 글은 AI 답변의 출처로 잡히기 어렵다. 그래서 원본은 홈페이지에 두고, 네이버 블로그에는 네이버 검색 노출을 위해 같은 글을 함께 올린다. 홈페이지는 구글과 AI 검색을, 블로그는 네이버 검색을 맡는 구조다.
상황별 대처
상황마다 검색엔진의 권고가 다르다. 신디케이션과 네이버 블로그 동시 게시는 공식 기준이 없거나 검색엔진마다 권고가 다른 경우다.
| 상황 | 구글 | 네이버 | Bing·AI 검색 |
|---|---|---|---|
| http·https, www 혼재 | 301 리디렉션(강한 신호). 다른 문제가 없으면 HTTPS를 대표로 선호한다. | 대표 주소로 301 리디렉션 | 중복 URL을 줄이면 Bing이 답변 근거로 쓸 URL을 고를 때 확신이 높아진다. |
| URL 파라미터·정렬·필터 | rel=canonical로 통합. 대형 사이트에서 합칠 수 없는 정렬 변형은 크롤링 관리 목적의 robots.txt 차단 허용 | 301이 어려우면 rel=canonical | canonical은 보조 수단이고, URL 수 자체를 줄이라는 입장 |
| 모바일 별도 URL | 데스크톱 URL이 항상 대표, 모바일은 대체 URL | 대표 주소를 하나로 정리 | 같음 |
| 같은 언어의 지역 변형 | canonical과 hreflang | – | – |
| 번역본 | 중복 아님. hreflang으로 관계만 표시 | – | – |
| 다른 매체에 전재(신디케이션) | canonical은 권하지 않는다. 파트너 쪽에서 색인을 막는 것이 가장 효과적이라고 안내 | 별도 권고는 공개되지 않았다. 원본이 사본보다 부당한 대우를 받지 않게 한다는 검색 원칙만 있다. | 파트너가 원문을 가리키는 canonical을 넣거나, 전문 대신 발췌와 원문 링크를 싣는다. |
| 홈페이지와 네이버 블로그에 같은 글 | 공식 기준은 공개되지 않았다. 원본은 홈페이지에 두고 네이버 블로그에도 함께 발행한다. 구글에서는 중복을 크게 걱정하지 않아도 되고, 네이버에서는 블로그 영역 노출을 얻는다. 외부 AI 봇이 읽을 수 있는 쪽은 홈페이지다. | ||
| 남이 내 글을 베꼈을 때 | 대부분 원본을 제대로 알아본다. 복제본이 대표로 뽑힌 드문 경우에만 DMCA 신고 | 원본이 사본보다 부당한 대우를 받지 않도록 노력한다는 원칙. 무단 전재는 검색 제외·게시 중단 요청 | 복제본이 인용된 사례가 있다. 원문 쪽으로 신호를 모으는 것이 현실적인 대응이다. |
| 사이트 이전·URL 변경 | 리디렉션이 강한 신호 | 301 우선 | canonical 태그가 아니라 리디렉션을 쓰라고 명시 |
Bing은 페이지를 합치거나 canonical을 바꿨을 때 IndexNow로 바로 알리라고 권한다. 구글은 정규화 문제 해결 문서에서 묶음을 다시 평가하는 데 최대 2주가 걸릴 수 있다고 적었다. 고치고 며칠 동안은 결과가 그대로일 수 있다.
먼저 할 일
중복을 벌점이 아니라 대표를 고르는 문제로 보면 할 일이 단순해진다. 이 내용의 원본이 어디인지 검색엔진과 AI가 헷갈리지 않게 하면 된다. 주소는 리디렉션으로 하나로 모으고, canonical로 선호를 알리고, 내부 링크는 대표 URL로 통일한다. 보도자료나 신디케이션처럼 다른 매체에 싣는 글은 전문 대신 요약과 원문 링크를 두고, 네이버 블로그에는 네이버 노출을 위해 같은 글을 함께 올린다. 구글 말대로 이 가운데 필수는 없지만, 함께 할수록 효과가 쌓인다.
하지 말아야 할 일도 분명하다. 남의 글을 가져와 단어만 바꾸는 것, AI로 표현만 바꿔 대량으로 올리는 것, 같은 콘텐츠로 사이트를 여러 개 만드는 것은 중복 관리가 아니라 스팸 정책의 문제다. 결과도 덜 보이는 정도로 끝나지 않고 검색 결과에서 빠지거나 순위가 떨어진다. 네이버가 특정 기술을 썼는지만으로 판단하지 않는다고 적은 것처럼, 기준은 도구가 아니라 새로 더한 내용이 있느냐다.
AI 검색이 늘면서 하나가 더해졌다. 대표로 뽑히지 못한 페이지는 AI 답변에 인용될 기회도 줄어든다. Bing은 공식적으로 그렇게 설명했고, 구글 문서를 엮어 봐도 같은 방향이다. 네이버 블로그가 주요 AI 봇을 막는다는 점까지 더하면, 회사가 쌓은 정보의 원본은 홈페이지에 두는 게 맞다.
자주 묻는 질문
Q. 중복 콘텐츠 페널티가 정말 없나요?
Q. 같은 글을 홈페이지와 네이버 블로그에 올려도 되나요?
Q. canonical 태그는 꼭 달아야 하나요?
Q. 다른 사이트가 제 글을 베꼈는데 제가 손해를 보나요?
Q. AI로 문장을 다시 쓰면 중복이 아닌가요?
Q. 중복 콘텐츠가 AI 답변 인용에도 영향을 주나요?
참고 자료
아래는 본문 서술의 바탕이 된 공개 자료입니다.
- Google Search Central — What is URL canonicalization (정규화 문서)
- Google Search Central Blog — Demystifying the “duplicate content penalty” (2008-09-12)
- Bing Webmaster Blog — Does Duplicate Content Hurt SEO and AI Search Visibility? (2025-12-19)
- 네이버 검색 공식블로그 — 유사문서 정의와 원본 노출 안내 (2016-12-02)
- 네이버 서치어드바이저 — 웹사이트 검색 최적화 가이드: 중복 문서와 대표 URL